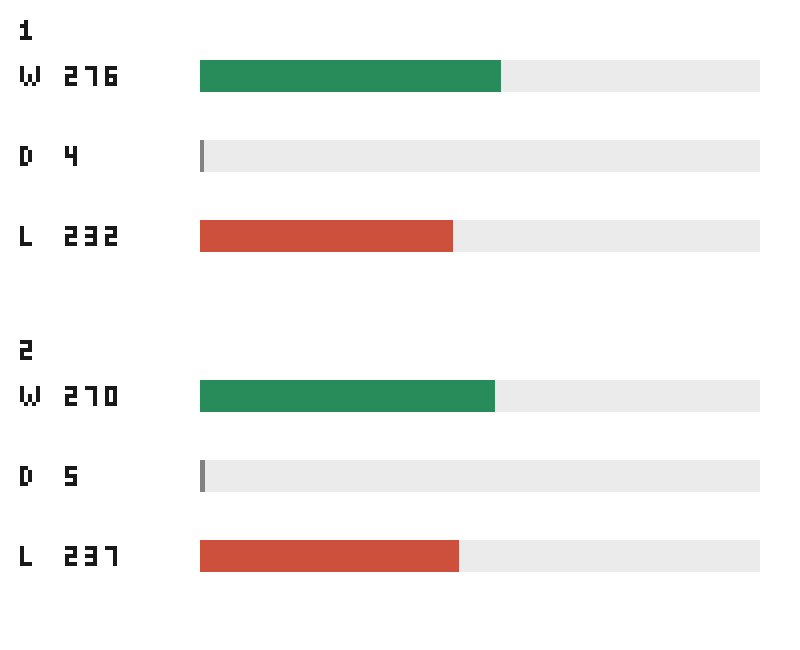
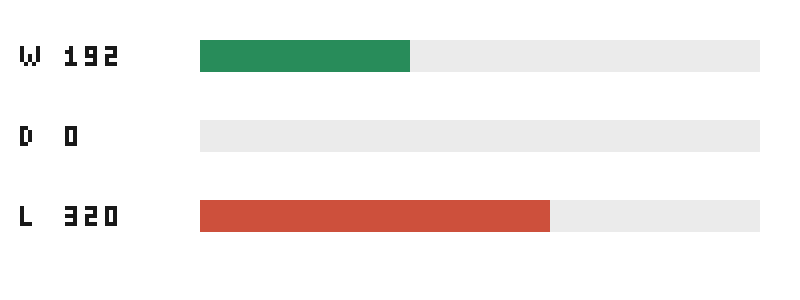
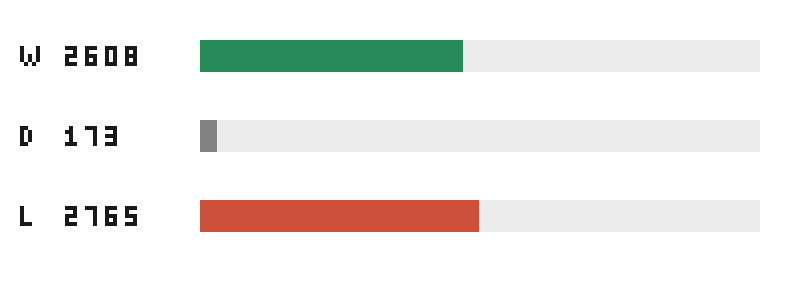DL水匠、AobaZero、Ryfamateの3種類の教師信号を同じ割合で混ぜ、そのデータで追加学習した局面評価用のニューラルネットワーク(NNUE)の棋力を測定しました。比較対象は、Ryfamateの割合が半分になる混ぜ方と、既存のDL水匠・AobaZeroの2教師平均です。
3教師を均等に混ぜた条件の推定値は、どちらの比較でも約+4.3 Eloでした。ただし、2系列の学習結果をまとめた95%信頼区間は、どちらも0を含みました。今回の条件では改善を確認できず、現行の最良構成(champion)は変更していません。
何を比較したか
教師信号は、教師モデルが各局面に付けた評価値です。評価値を平均して学習用の正解を作る処理を、ここでは「アンサンブル」と呼びます。対局させたのは教師モデル自体ではなく、その正解を使って追加学習したNNUEです。
| 条件 | 教師評価値の混ぜ方 |
|---|---|
| A:既存の2教師平均 | DL水匠とAobaZeroをそれぞれ1/2 |
| B:段階的な平均 | まずDL水匠とAobaZeroを平均し、その結果とRyfamateを半分ずつ混ぜる。最終的な寄与は1/4、1/4、1/2 |
| C:3教師の均等平均 | DL水匠、AobaZero、Ryfamateをそれぞれ1/3 |
BとCはRyfamateの寄与が異なります。また、評価値を整数で保存するため、Bでは平均を2回取る際の丸めも入ります。今回の対局では寄与率と丸めの効果を別々には測定していないので、差を寄与率だけの効果とは断定しません。平均処理とは別の評価値の較正(分布やスケールの調整)は行っていません。
学習条件
3条件とも、同じ保存済みの学習状態(checkpoint)から開始しました。今回はランダムな重みから新しく学習する比較ではなく、同じ親からの追加学習の比較です。
- 同じ20,004,864局面を10回使用。1条件・1系列あたりの延べ処理数は200,048,640局面、更新回数は12,210回。
- 学習データの順序を決める乱数の設定値(seed)は2026101101と2026101102の2種類。同じseedの条件間で局面と学習順序を合わせる。
- 学習ソフトTataraを使用。ネットワークの各層のサイズはft_out=768、l1=8、l2=32で、進行度を8段階に分ける設定も共通。
- 誤差指標はWRM lossのpower=2.75で共通。1回の更新に使う局面数(バッチサイズ)は16,384。
- 学習の更新を計算する内部状態(optimizer、RangerのLookahead)と更新回数の記録を親から継承。学習率のスケジュールだけをリセットし、4.375×10^-5で固定。
AとBは同条件で作成・検査済みのモデルを再利用し、Cを2 seedで新たに学習しました。以下の4つの対局測定は、すべて今回新しく行っています。Ryfamateを含む実験は非営利の開発として実施しています。
対局条件
短い持ち時間での比較(STC)として、各側10秒、1手ごとに0.1秒加算で対局しました。各エンジンは1スレッド、Hash 128 MiB、64局同時実行です。思考エンジンとその他の設定は共通にし、評価値の換算設定FV_SCALEは24に固定しました。先読み(Ponder)は無効です。
各比較・各seedで8,192局、同じ開始局面で先後を入れ替えた4,096ペアを実施しました。4測定で同じ開始局面列を使い、元の開始局面集に含まれる重複も保持しています。入玉ルールはCSARule24、手数上限は開始局面以前を含め512手です。
これは事前に局数を固定した探索的な比較で、途中の結果から終了を決める逐次検定(SPRT)ではありません。重い学習と対局は重ねず、全ペアの完結とエンジンの終了を確認しました。時切れ、反則、engine errorは0件でした。
結果
勝ち・引き分け・負けとElo差は、すべてC(3教師の均等平均)側から見た値です。Elo差は強さの差の推定値で、正ならCのほうが強い方向です。95%信頼区間は、対局結果に基づく推定の幅を示します。区間が0を含む場合、今回の対局では強さの差があると確認できません。
各seedの行は8,192局、「2 seed合計」の行は16,384局の結果です。
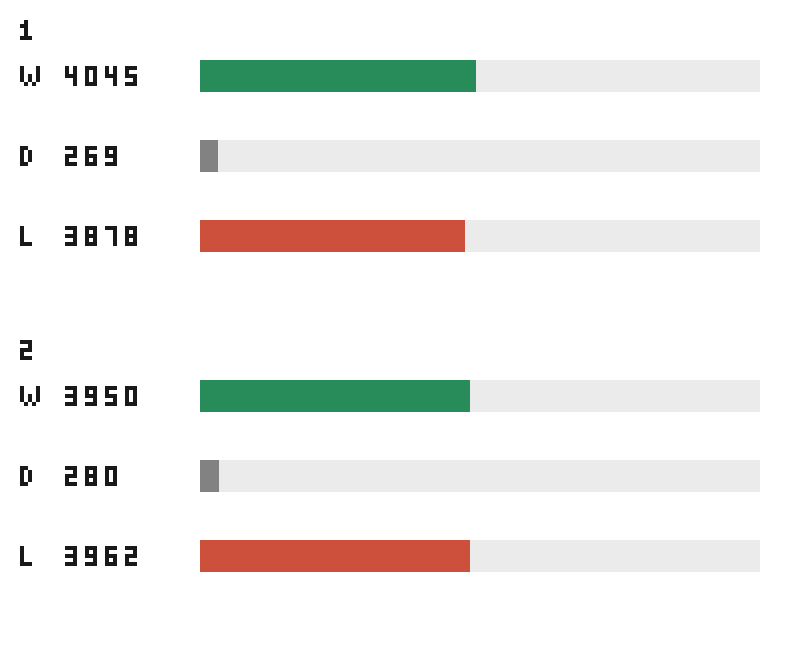
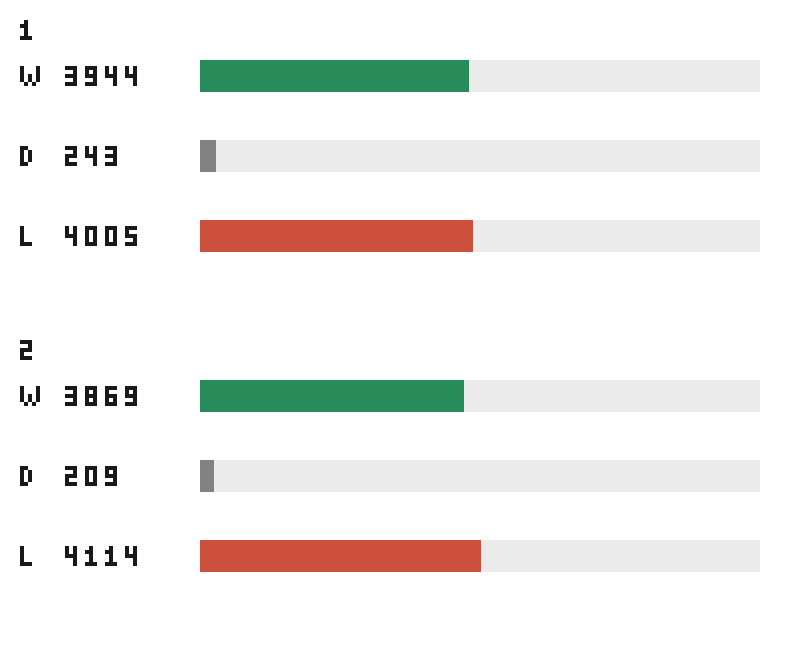
| 比較相手 | 学習seed | Cの勝ち・引き分け・負け | Elo差 | 95%信頼区間 |
|---|---|---|---|---|
| B:段階的な平均 | 2026101101 | 4,061・262・3,869 | +8.1 | [+0.6, +15.7] |
| B:段階的な平均 | 2026101102 | 3,943・318・3,931 | +0.5 | [-7.0, +8.0] |
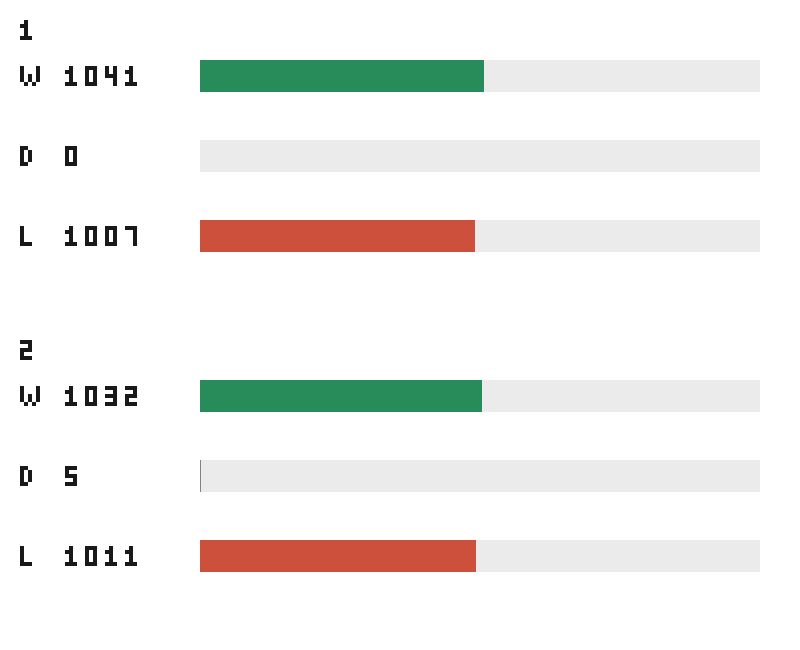
| B:段階的な平均 | 2 seed合計 | 8,004・580・7,800 | +4.3 | [-1.0, +9.6] |
| A:既存の2教師平均 | 2026101101 | 3,999・263・3,930 | +2.9 | [-4.6, +10.5] |
| A:既存の2教師平均 | 2026101102 | 4,029・268・3,895 | +5.7 | [-1.8, +13.2] |
| A:既存の2教師平均 | 2 seed合計 | 8,028・531・7,825 | +4.3 | [-1.0, +9.6] |
相手の異なる対局を一つにまとめず、Bとの比較、Aとの比較をそれぞれ16,384局で集計しました。各seedの推定値はどちらの比較も正でしたが、両方の合計の信頼区間が0を含みます。「強くなった」とも「効果がない」とも、今回の結果だけでは確定できません。
学習ロスの推移
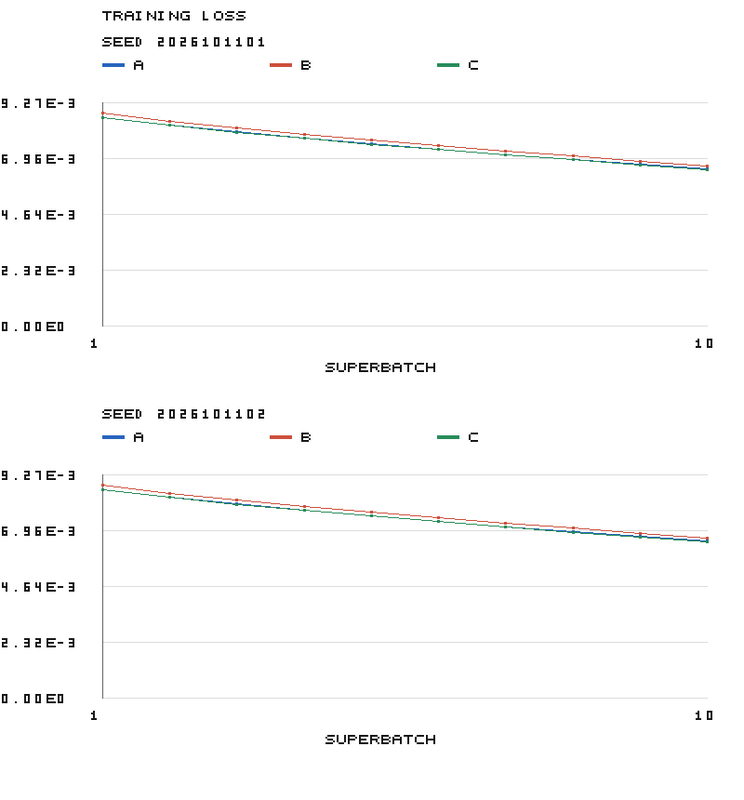
上段がseed 2026101101、下段が2026101102です。青のAは既存の2教師平均、赤のBは段階的な平均、緑のCは3教師の均等平均です。横軸のsuperbatchは今回のデータ20,004,864局面を1回使う単位、縦軸は訓練ロス(WRM loss、power=2.75)です。記録された10点を直線で結び、両段で同じ縦軸の範囲を使っています。AとCの曲線は近く、重なって見える部分があります。公開時に縮小された図ですが、両段の曲線・凡例・軸を確認して掲載しています。
記録された訓練ロスは、全6系列で学習の初回より最終回のほうが小さくなりました。最終回は、Aが約0.00652、Bが約0.00666、Cが約0.00650です。AとCの推移は近く、Bはやや大きい値でした。
ここでいう訓練ロスは、学習に使った局面について教師の正解とのずれを測る値です。教師信号が条件によって違うので、Cのロスが小さいことを、そのまま棋力の優位とは解釈しません。独立した検証データのロスは記録していないため、学習データに合わせすぎる「過学習」の有無も、この訓練ロスだけでは確認できません。
採否と限界
実験前に、次段階へ進む条件を「両比較で各seedのElo推定値が正、かつ各比較の2 seed合計の95%信頼区間の下限も正」と固定しました。今回は後半の条件を満たさず、この比較から大規模蒸留・追加学習や長い持ち時間の確認へは進めませんでした。championとの直接比較や昇格も行っていません。
学習seedは2種類だけです。表示した信頼区間は、この2種類の学習済みモデルの対局結果に基づくもので、別の学習seedから作ったモデル全体のばらつきまで十分に含むものではありません。同じ親からの追加学習という条件なので、ランダムな初期値から学習した場合や別のデータ量、持ち時間への一般化もできません。
この実験の結論は「3教師の均等平均に小さな正の推定値は見られたが、今回の2 seed・固定局数では改善を確認できなかった」です。提案そのものを検証済みとして撤回することはせず、今回の結果と限界を次の計画の参考として残します。
実験ID:e9088e06-54d8-4e88-ab21-bd5efbf32cba